数据结构-栈、堆、数组(3)
数据结构-栈、堆、数组(3)
4FGR3.1 栈
**栈(stack)**是仅允许在一端进行插入(入栈)和删除(出栈)操作的线性表。
- 栈顶(Top): 允许进行插入或删除的一端。
- 栈底(Bottom): 固定不变,不允许增删的一端。
- 空栈:不含任何元素的栈。
栈的基本操作
- InitStack(&S) 初始化一个空栈
- StackEmpty(S) 判断栈是否为空。
- Push(&S,x) 入栈,栈未满就压入 \(x\)
- Pop(&S,&x): 出栈,非空就弹出栈顶,取出 \(x\)
- GetTop(S,&x):读栈顶
- DestroyStack(&S): 销毁栈
\(n\) 个不同元素进栈,出栈元素不同排列的个数为 \(\frac{1}{n+1}C_{2n}^n\) ,该公式为卡特兰数。
栈的顺序存储结构
采用顺序存储的栈称为顺序栈,用 \(top\) 指向栈顶元素
1 |
|
顺序栈的基本操作
1.初始化
1 | void InitStack(SqStack &S){ |
2.判栈空
1 | bool StackEmpty(SqStack S){ |
3.入栈
1 | bool Push(SqStack &S,ElemType x){ |
4.出栈
1 | bool Pop(SqStack &S,ElemType &x){ |
5.读栈顶元素
1 | bool GetTop(SqStack S,ElemType &x){ |
共享栈
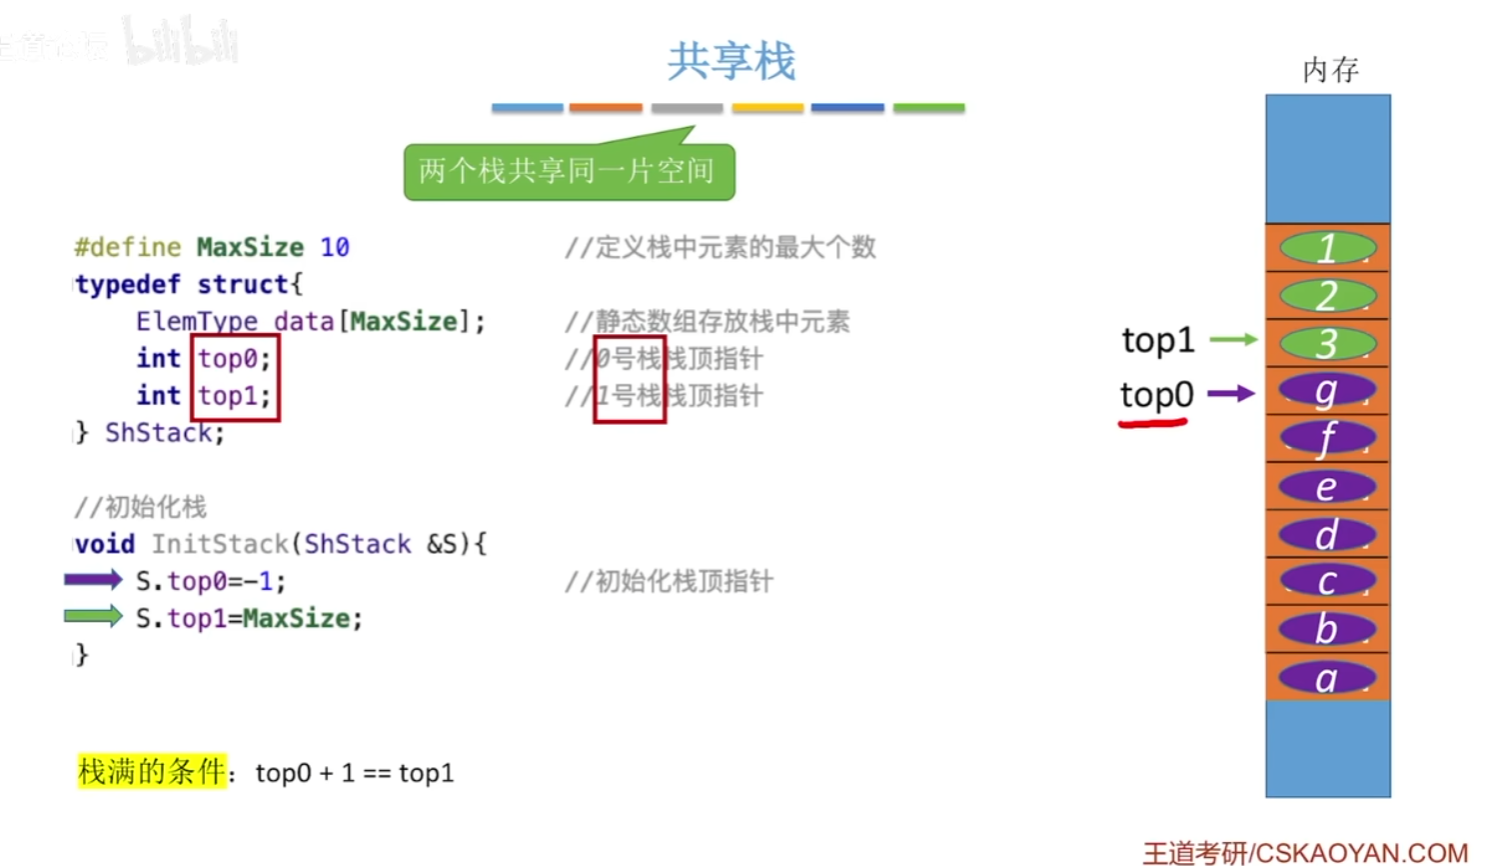
栈的顺序存储结构
链栈的定义(推荐不带头结点)
1 | typedef struct LinkNode{ |
3.2 队列
队列(Queue)是只允许在一端进行插入,在另一端删除的线性表。
- 队头/队首(front):允许删除的一端
- 队尾(Rear):允许插入的一端
队列的顺序实现
1 |
|
循环队列的基本操作
1.初始化
1 | void InitQueue(SqQueue &Q){ |
2.判空
1 | bool QueueEmpty(){ |
3.入队
1 | bool EnQueue(SqQueue &q,ElemType x){ |
4.出队
1 | bool DeQueue(SqQueue &Q,ElemType &x){ |
队列的链式存储
定义
1 | typedef struct LinkNode{ |
链式队列的基本操作
1.初始化
1 | void InitQueue(LinkQueue &Q){ |
2.判队空
1 | bool QueueEmpty(LinkQueue Q){ |
3.入队
1 | void EnQueue(LinkQueue &Q,ElemType x){ |
4.出队
1 | bool DeQueue(LinkQueue &Q,ElemType &x){ |
双端队列
双端队列是允许在两端进行插入和删除的线性表。
输出受限的双端队列:允许在一端进行插入和删除,但在另一端仅允许插入的双端队列。
输入受限的双端队列:允许在一端进行插入和删除,但在另一端仅允许删除的双端队列。若限定双端队列从某个端点插入的元素只能从该端点删除,则该双端队列就蜕变尾两个栈底相邻的栈。
3.3 栈和队列的应用
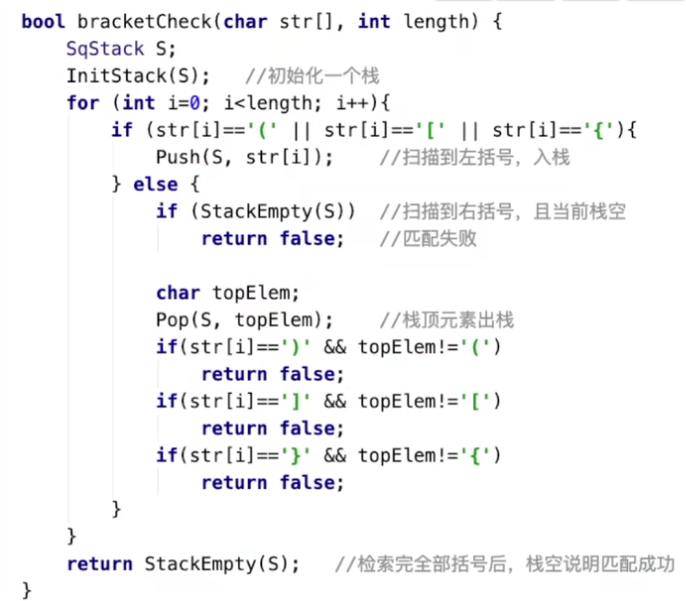
栈在括号匹配中的应用
遇到左括号就入栈,遇到右括号,就“消耗”一个左括号
如果出栈至栈空,也没有左括号与之匹配,说明非法。
不同的右括号遇到了左括号,说明非法,比如 “[ ) ]” 或 “( ] )”
栈在表达式求值的应用
1.算术表达式
中缀表达式是我们熟悉的算术表达式,运算符位于两个操作数之间,但不利于计算机直接求值,而且必须依赖括号来明确运算次序。
2.中缀表达式转后缀表达式
手算法
① 确定中缀表达式中各个运算符的运算顺序
② 选择下一个运算符,按照 「左操作数 右操作数 运算符」的方式组合成一个新的操作数
③ 如果还有运算符没被处理,就继续 ②
计算机中:
- 遇到操作数:直接加入后缀表达式
- 遇到界限符:若为 “(” ,直接入栈,若为 “)” ,不断弹出栈顶运算符并加入后缀表达式
- 遇到运算符:若优先级高于栈顶元素,就入栈;若优先级低于或等于栈顶元素,就不断出栈,直到栈顶元素优先级更高或者栈空,再入栈。这里认为 “(” 优先级最高。
栈的深度: 整个过程中栈中元素的最大个数
3.后缀表达式求值
扫描表达式,若为操作数,就入栈。
遇到运算符 op ,从栈中弹出两个元素 \(a,b\) ,把 a op b
的结果压回栈中。
所有结果完毕后,栈顶元素为最终计算结果。
栈在递归中的应用
在递归调用过程中,系统为每一层调用的返回地址、局部变量及形参等信息分配存储空间,这些信息被保存在递归工作栈中。因此,递归深度过大时容易导致栈溢出。
- 斐波那契
队列在层次遍历中的应用
在处理当前层的同时,把下一层的元素按序加入待处理的队列。
队列在计算机系统中的应用
- 解决主机与外部设备之间速度不匹配的问题
- 通常设置缓冲区解决。缓存区满则让主机做其他任务,否则打印机发出请求,让主机向缓冲区写入新数据。
- 解决由多用户引起的资源竞争问题。
- 比如CPU资源的竞争。把CPU资源分配给队首用户,运行结束或者用完时间片就出队,然后分配给新的队首用户。
3.4 数组和特殊矩阵
数组
一维数组
数据元素 \(a[i]\) 的存放地址为 \(LOC(a_i)=LOC(a_0)+iL\) ,\(L\) 为单个元素所占存储单元数。
对于二维数组 \(a[n][m]\)
按行优先:先存储行号小的元素,再存储列号小的元素
\(LOC(a_{i,j})=LOC(a_{0,0})+jL+i*mL\) 。
按列优先,显然与上述相反。
\(LOC(a_{i,j})=LOC(a_{0,0})+iL+j*nL\)
特殊矩阵的压缩存储
对称矩阵
对称矩阵的压缩存储,存储主对角线+上三角/下三角矩阵即可,最后大小为 \(\frac{(n+1)n}{2}\) 。
存储主对角线+下三角
矩阵中的 \(a_{i,j}\) 元素(\(i,j\geq1\))是数组(这个下标从 \(0\) 开始)中第 \(i*(i-1)/2+j-1\) 个元素
显然,上三角区域的 \(a_{j,i} = a_{i,j}\) ,对应的元素下标计算时把 \(i,j\) 互调即可。
对应的数组下标为 \(j*(j-1)/2+i-1\) \[ k = \begin{cases} i*(i-1)/2+j-1&i\geq j \\ j*(j-1)/2+i-1&i<j \end{cases} \]
三角矩阵
在下(上)三角矩阵中,上(下)三角区的所有元素均为同一常量,故类似于对称矩阵
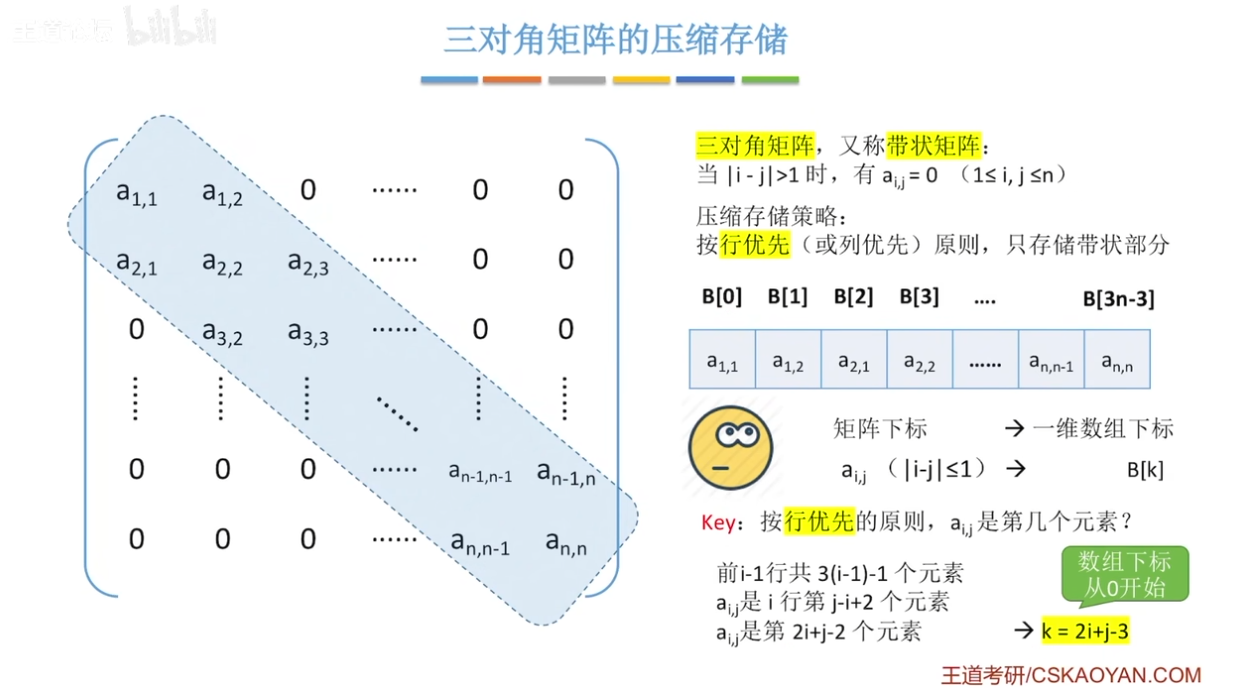
下三角矩阵的压缩存储: \[ k = \begin{cases} \frac{i(i-1)}{2}+j-1&i\geq j \\ \frac{n(n+1)}{2}&i<j \end{cases} \] 上三角矩阵的压缩存储 \[ k = \begin{cases} \frac{(i-1)(2n-i+2)}{2}+(j-i) &i\leq j \\ \frac{n(n+1)}{2}&i>j \end{cases} \] 三对角矩阵
稀疏矩阵的压缩存储
若矩阵中非零元素的个数非常少,则称该矩阵为稀疏矩阵。
可用元素为三元组的数组依次存取
(行,列,值) 。
这种方法简单,但插入和删除的效率较低。
十字链表法 通过链表的方式组织三元组,适用于频繁插入和删除操作的场景。