数据结构-查找(7)
数据结构-查找(7)
4FGR7.1 查找的基本概念
- 查找:在数据集合中寻找满足某种条件的数据元素的过程称为查找
- 查找表(查找结构):用于查找的数据集合称为查找表,它由同一类型的数据元素(或记录)构成
- 关键字:数据元素中唯一标识该元素的某个数据项,使用基于关键字的查找,查找结果应该是一样的
评价指标
- 查找长度:需要对比关键字的次数
- 平均查找长度(ASL):查找过程中进行关键字的比较次数的平均值
ASL一般分为查找成功和查找失败的情况
7.2 顺序查找和折半查找
顺序查找
按着下标顺序依次往后找。
可加入“哨兵”,数组第 \(0\) 个位置是哨兵,从后往前查找,显然,如果查找失败,则返回下标 \(0\) 。
时间复杂度 \(O(n)\)
折半查找(二分查找)
仅适用于有序的顺序表
例如,\([l,r]\) 区间有序(升序),那么用 \(mid\) 指针指向中间 \(mid=(l+r)/2\) ,如果 \(mid<k\) ,则搜索 \([l,mid-1]\) 的区间,也就是 \(r=mid-1\) ;如果相等,就返回下标;否则,搜索 \([mid+1,r]\) ,\(l=mid+1\) ,不断搜索,如果 \(l>r\) ,说明查找失败。
时间复杂度 \(O(\log n)\)
1 | int Binary_Search(SSTable L,ElemType key){ |
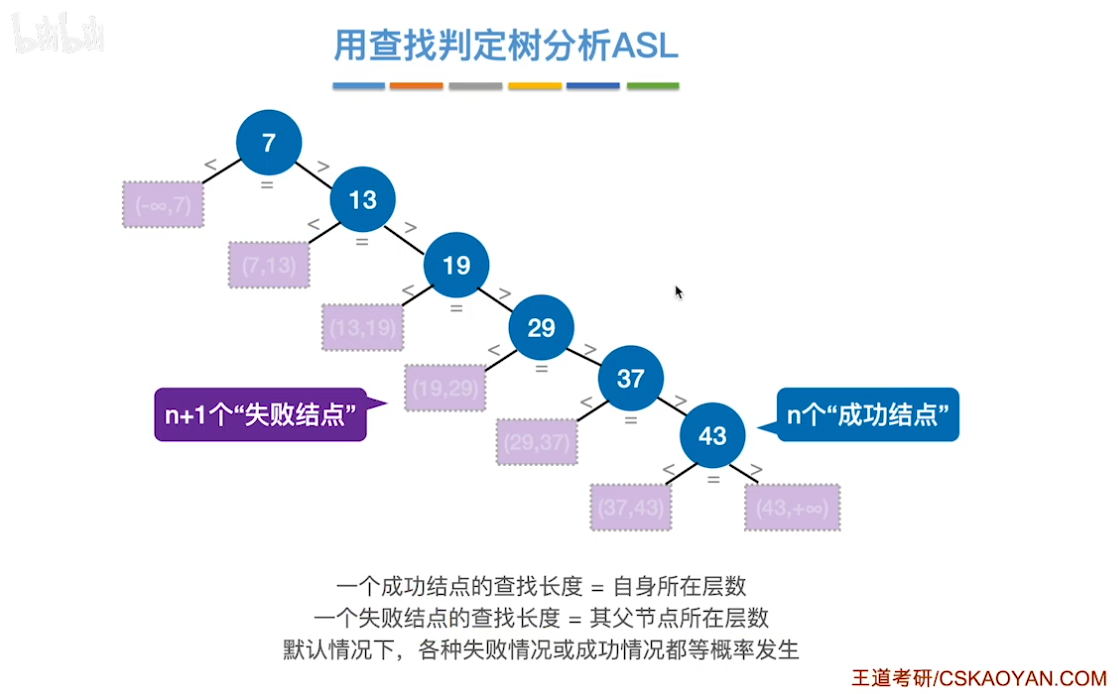
显然,在查找判定树中,若 \(mid=\lfloor (low+high)/2\rfloor\) ,,则对于任何一个结点,必有: \[ 右子树结点-左子树结点数=0或1 \]
若改成向上取整,则反过来
折半查找的判定树一定是平衡二叉树,树高 \(h=\lceil \log_2(n+1)\rceil\) (不含失败结点)
分块查找
特点:块内无序,块间有序
“索引表”中保存每个分块的最大关键字和分块的存储区间。
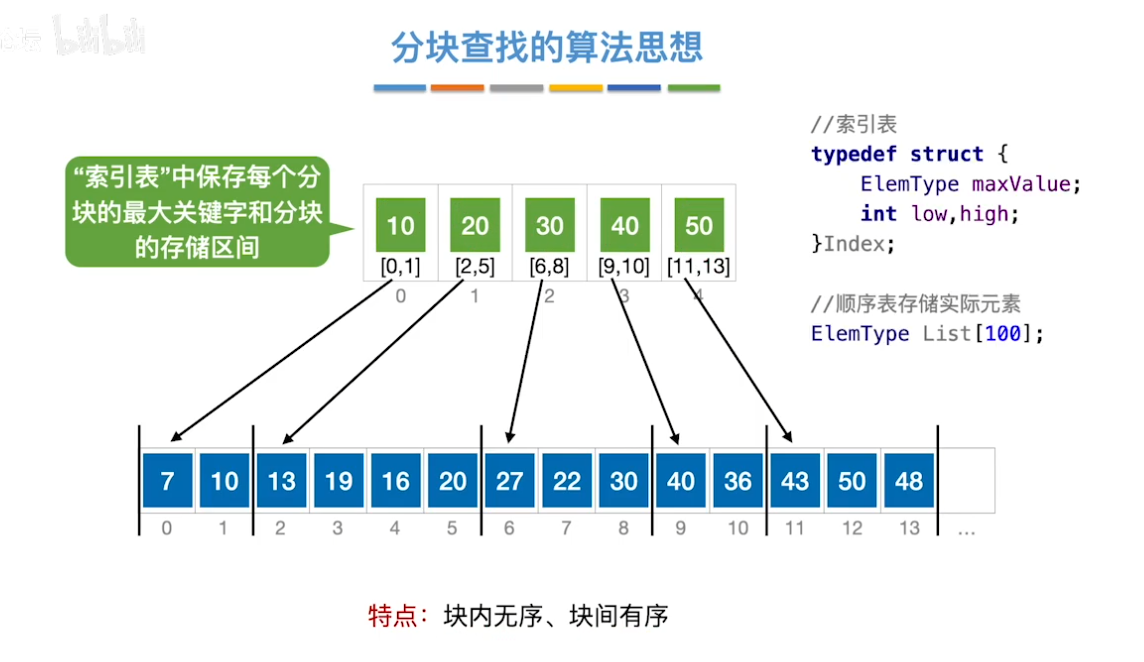
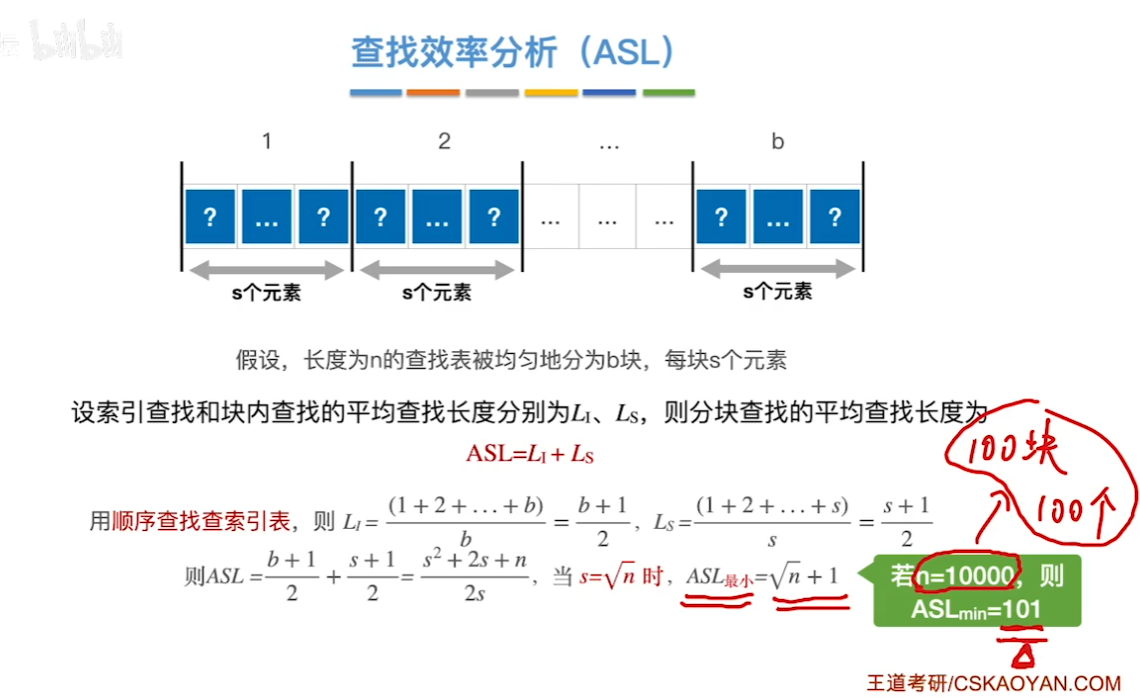
可使用折半查找去查找索引
7.3 树形查找
二叉排序树(BST)
二叉排序树,又称二叉查找树(Binary Search Tree)一颗二叉树或者是空二叉树,或者是具有如下性质的二叉树:
- 左子树的所有结点关键字均小于根节点的关键字
- 右子树的所有结点关键字均大于根节点的关键字
对BST进行中序遍历,可以得到一个升序序列
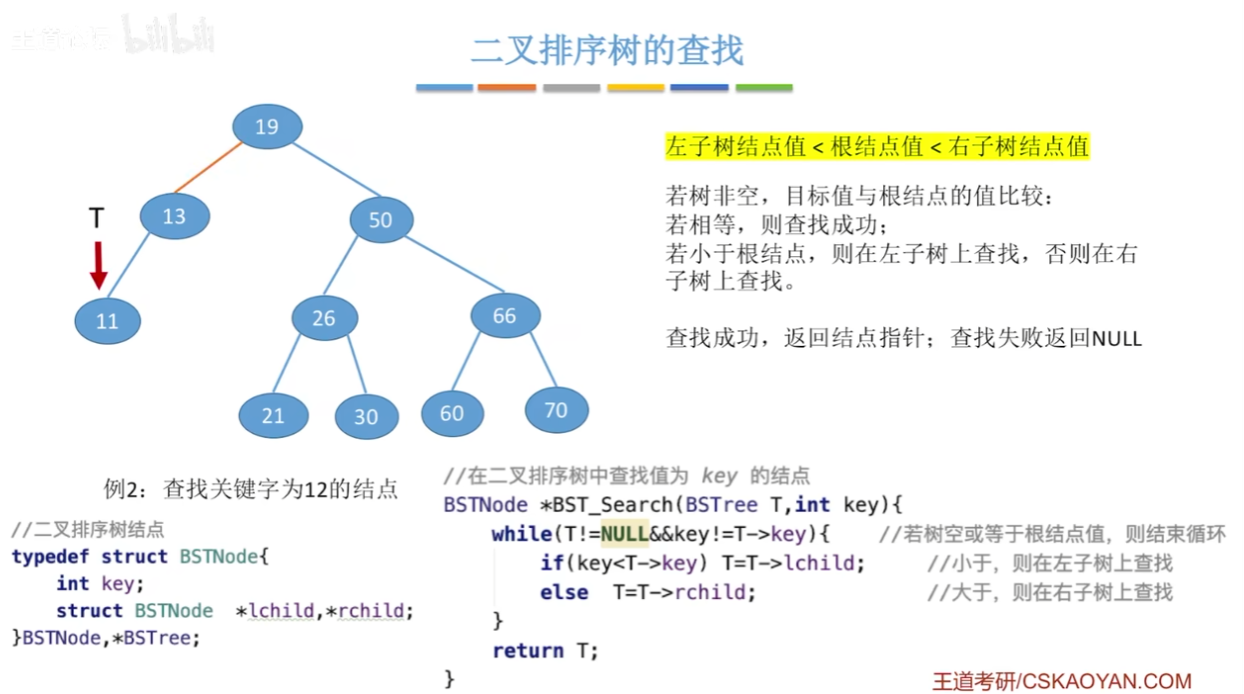
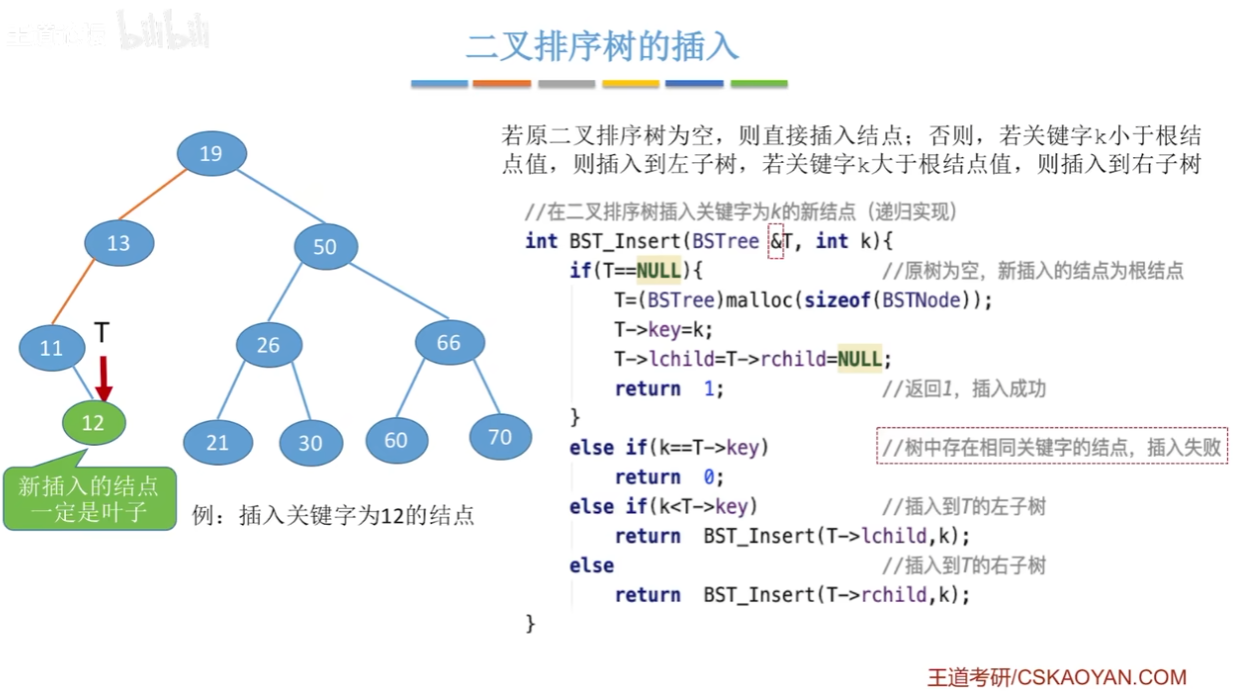
1 | void Creat_BST(BSTree &T,int str[],int n){ |
二叉排序树的删除
对于被删结点 \(z\)
- \(z\) 是叶子节点,直接删除
- \(z\) 的度为 \(1\) ,则将唯一的子树上移
- \(z\) 的度为 \(2\) ,用 \(z\) 的直接后继(或直接前驱)替代 \(z\) ,然后删去这个直接后继(直接前驱)。
\(z\) 的前驱:\(z\) 的左子树中的最右下结点
二叉排序树的查找效率主要取决于树的高度
平衡二叉树(AVL)
平衡二叉树,是树上任一结点的左子树和右子树的高度只差不超过 \(1\)
结点的平衡因子=左子树高-右子树高
插入
每次插入时,调整最小的不平衡的子树(子树的根节点的平衡因子的绝对值大于 \(1\) )
1)LL 平衡旋转(右单旋转):由于结点 \(A\) 的左孩子(L)的左子树(L)上插入了新结点使 \(A\) 不平衡,需要一次向右的旋转操作,将 \(A\) 的左孩子 \(B\) 向右上旋转代替 \(A\) 为根节点,\(A\) 右下旋转为 \(B\) 的右孩子,\(B\) 的原右子树作为 \(A\) 的左子树
2)RR 平衡旋转(左单旋转):与 LL 同理,\(A\) 的右孩子 \(B\) 向左上旋转代替 \(A\) ,\(A\) 向右下旋转称为 \(B\) 的左孩子,\(B\) 的原左子树作为 \(A\) 的右子树
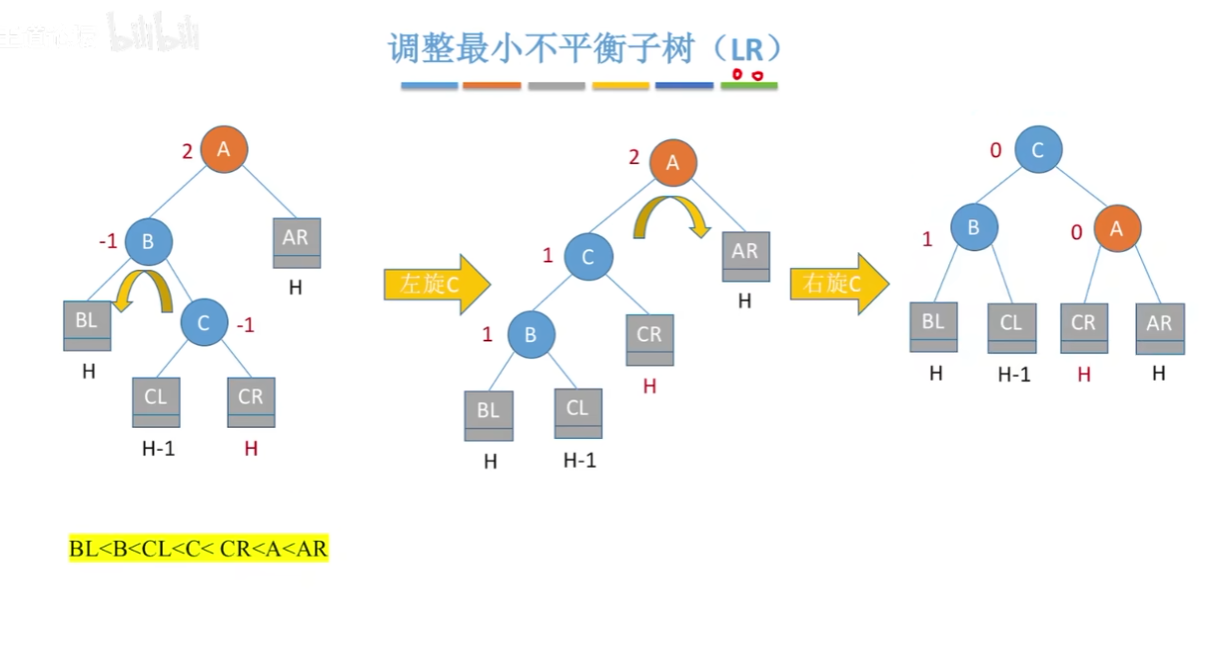
3)LR 平衡旋转(先左后右双旋转):\(A\) 的左孩子 \(B\) 的右孩子 \(C\) ,先向左上旋转替代 \(B\) ,再右上旋转替代 \(A\) 。
4)RL平衡旋转(先右后左双旋转):和 LR 同理,操作相反。
删除
删除结点后,也要保持特性不变
具体步骤
① 删除结点(方法同“二叉排序树”)
② 向上找到最小不平衡子树,找不到就结束
③ 找到最小平衡子树的根节点,其深度最高的子树的儿子、孙子
④根据孙子位置,调整平衡(LL/RR/LR/RL)
⑤ 如果不平衡向上传导,继续操作 ②
红黑树(RBT)
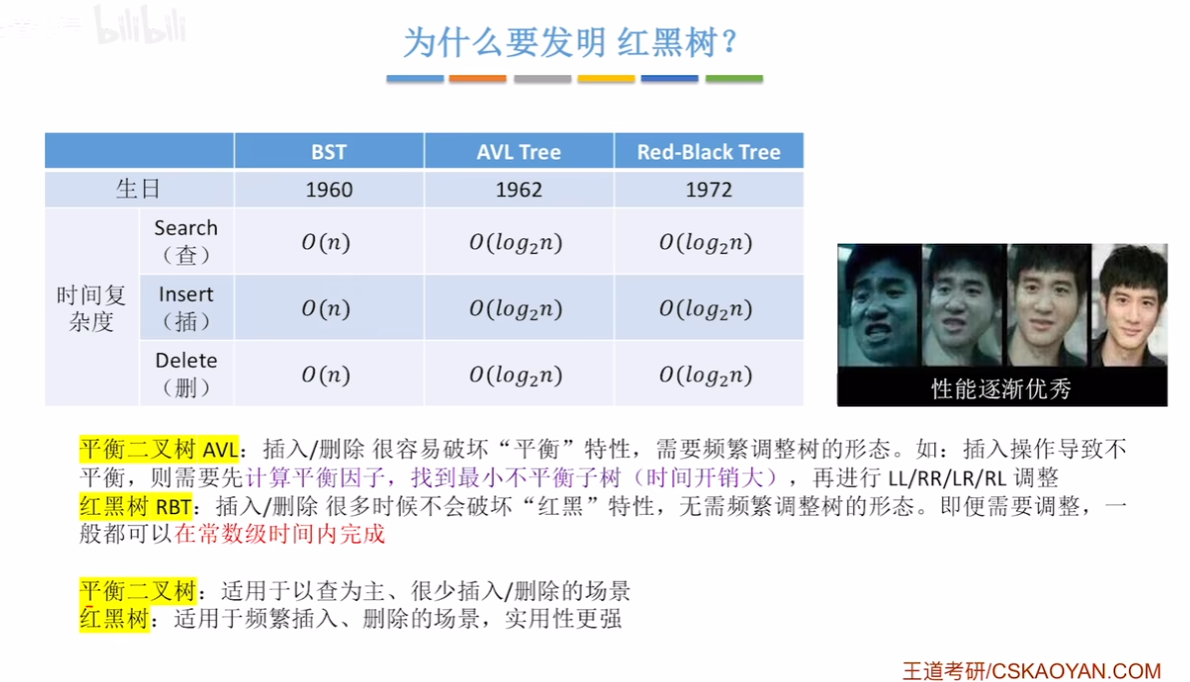
红黑树是二叉排序树
- 每个结点要么红要么黑
- 根结点是黑色
- 叶结点(外部结点、NULL结点、失败结点)是黑色
- 不存在两个相邻的红色结点
- 对每个结点,从该结点到任一叶结点的简单路径上,所含黑色结点的数目相同
结点的黑高——从某结点出发(不含该结点),到任一叶结点的路径上的黑色结点总数
查找和二叉排序树一致
性质
从根节点到叶节点的最长路径不大于最短路径的2倍
右 \(n\) 个内部节点的红黑树高度 \(h\leq 2\log(n+1)\)
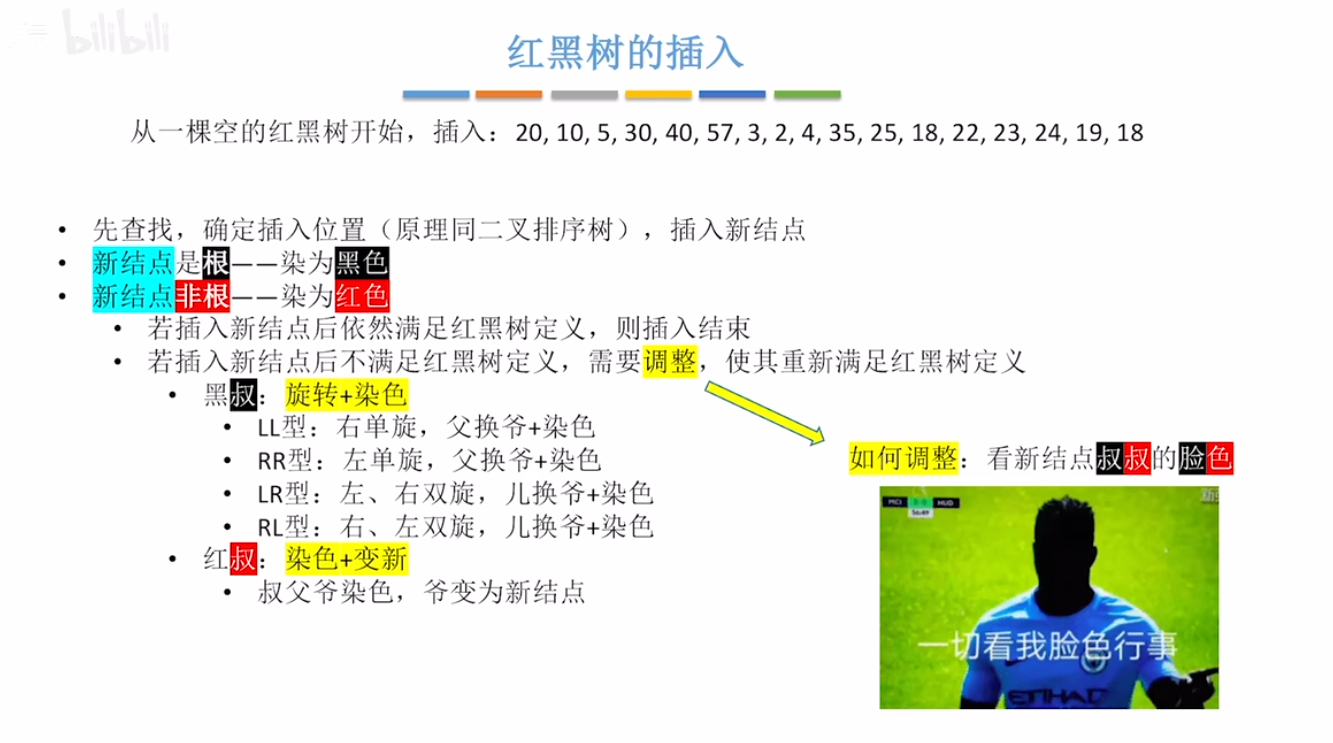
红黑树的插入
红黑树的删除
B树
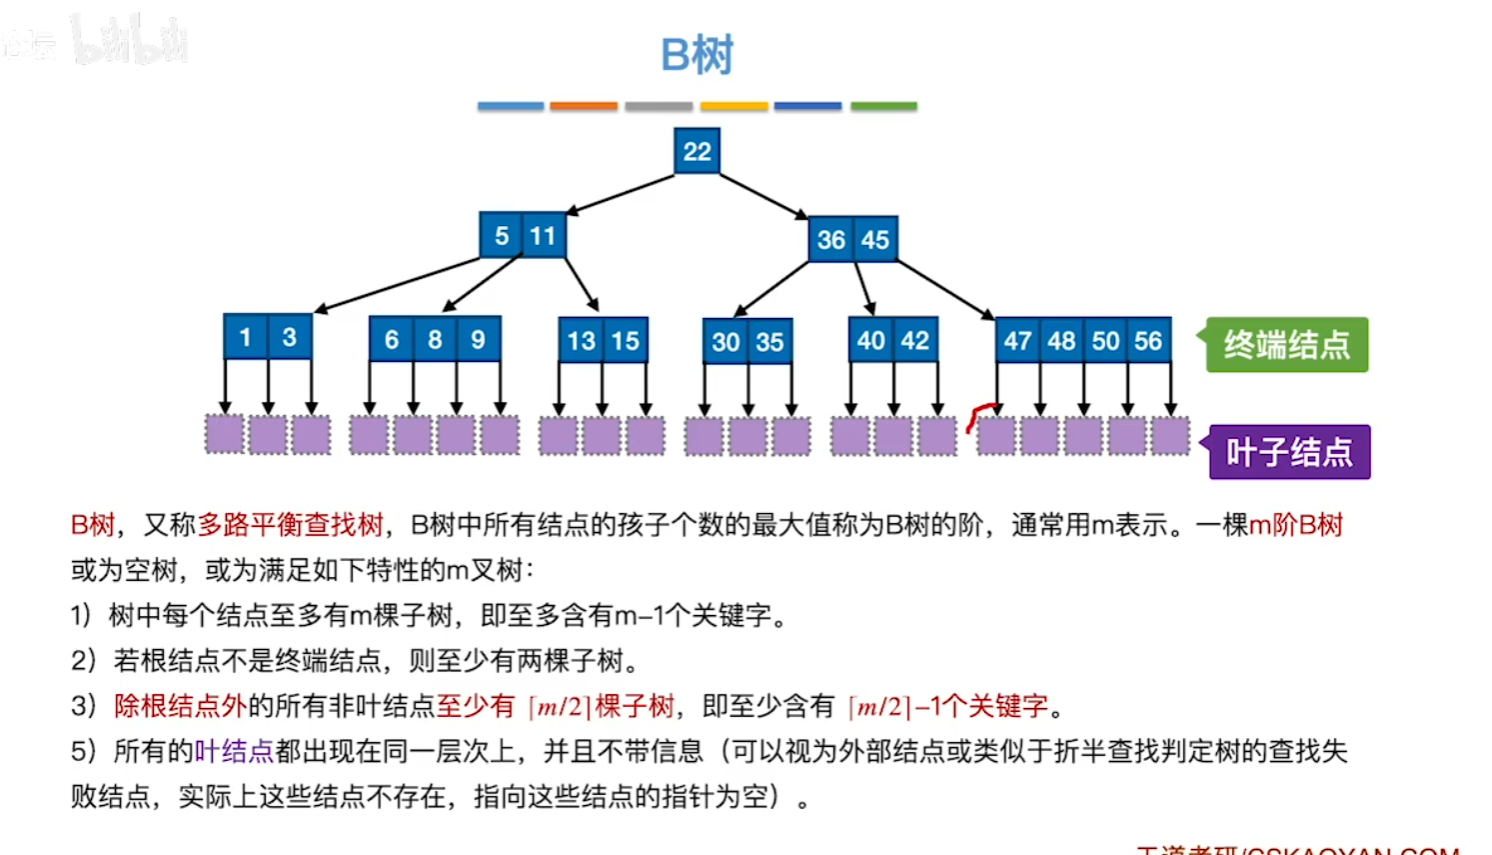
m 叉查找树中,规定除了根节点外,任何结点至少有 \(\lceil m/2 \rceil\) 个分叉,即至少含有 \(\lceil m/2 \rceil-1\) 个关键字。
m阶B树的核心特性
- 根节点的子树数 \(\in[2,m]\) ; 关键字数 \(\in [1,m-1]\),其他结点的子树数 \(\in [\lceil m/2 \rceil,m]\) ; 关键字数 \(\in [\lceil m/2 \rceil -1,m-1]\)
- 对任一结点,其所有子树高度都相同
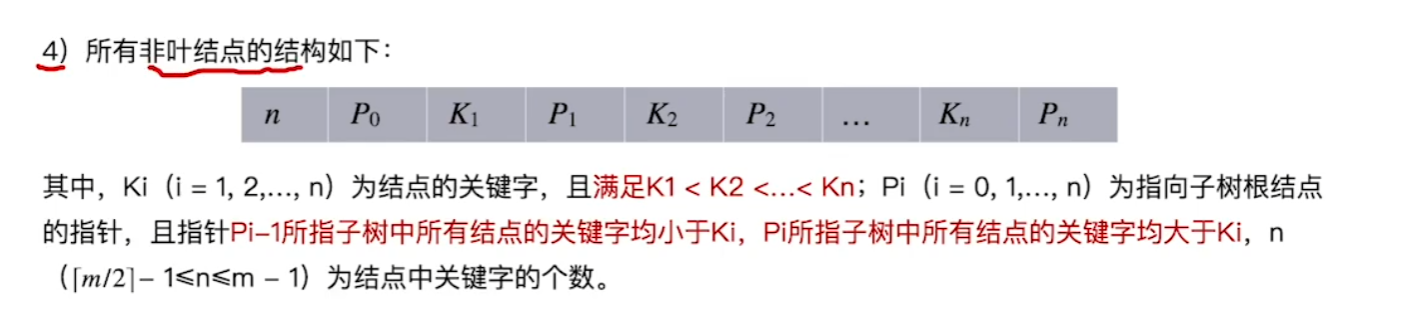
- 关键字的值:\(子树0<关键字1<子树1<关键字2<子树2<...\)
最小高度 \(h\geq \log_m{(n+1)}\)
最大高度 \(h\leq \log_{\lceil m/2 \rceil}\frac{n+1}{2}+1\)
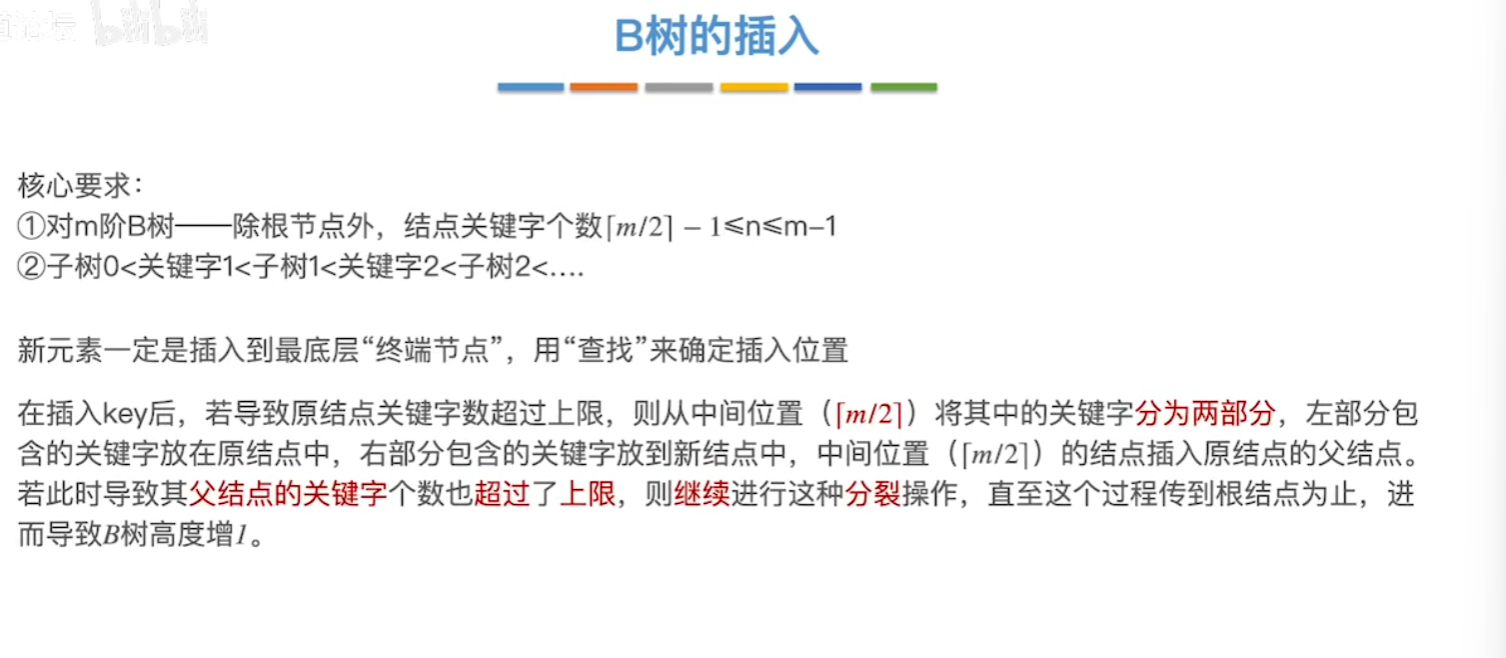
B树的插入
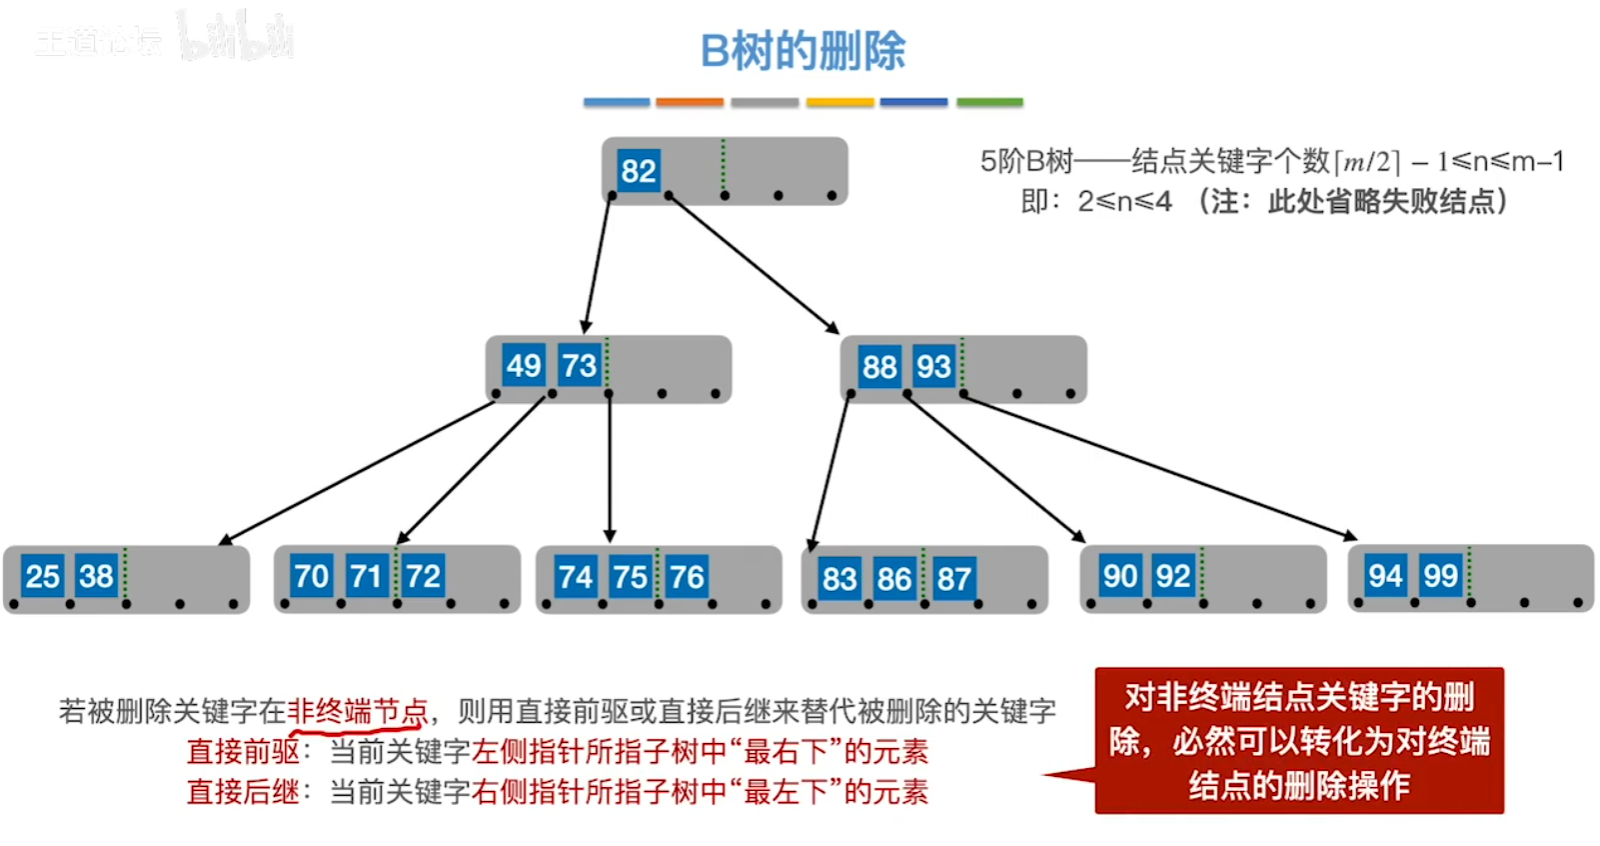
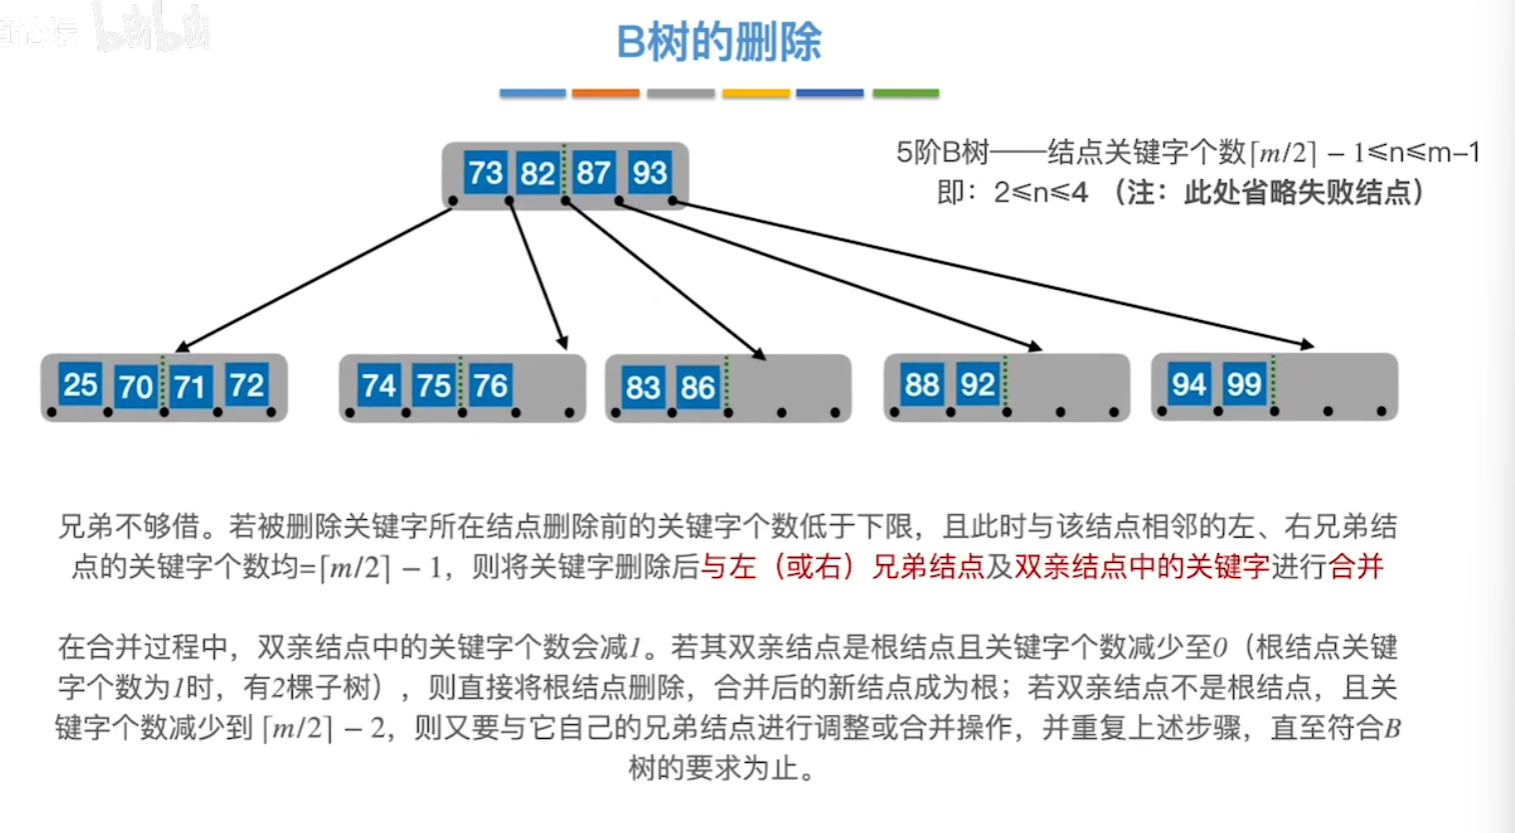
B树的删除
B+树


7.5 散列(hash)表
散列表(哈希表,Hash Table):一种可以根据数据元素的关键字计算出它在散列表中的存储地址
散列函数(哈希函数):Addr=H(key) 建立了“关键字”\(\rightarrow\)“存储地址”的映射关系
散列函数的构造方法
设计散列函数:
- 定义域必须涵盖所有可能的关键字
- 值域不能超出散列表的地址范围
除留余数法
\(H(key)=key \mod p\)
散列表表长为 \(m\) ,取一个不大于 \(m\) 的最大质数 \(p\)
直接定址法
\(H(key)=key\) 或 \(H(key)=a\times key+b\)
不会产生冲突,若关键字分布不连续,空位较多
数字分析法
选取数码分布较为均匀的若干位作为散列地址
使用场景:关键字集合已知,且关键字的某几位数码位分布均匀
平方取中法
取关键字的平方值的中间几位作为散列地址
适用场景:关键字的每位取值都不够均匀。
处理冲突的方法
拉链法
链表默认是头插法
散列到同一地址的所有同义词组织成一个链表,适合频繁插入、删除的情形。
一个小优化是,每次插入时保证链表有序。
开放定址法
如果发生冲突,就给新元素找另一个空闲位置
采用开放定址法时,不能直接物理删除,只能设置一个删除标记,否则可能截断其他同义词的查找路径,导致查找失败。
- 线性探测法
- 增量序列 \(d_i=0,1,2,...,m-1\)
- 冲突发生时,依次查看下一个单元,直到找到一个空闲单元
- 容易发生“聚集(堆积)”现象,大量元素在相邻地址上堆积,显著降低查找速度
- 平方探测法(二次探测法)
- 增量序列 \(d_i=1^2,-1^2,2^2,-2^2,...,k^2,-k^2\)
- 其中,长度 \(m\) 必须是一个形如 \(4k+3\) 的素数,才能探测到所有位置
- 缺点是无法探测散列表中的所有位置,但至少覆盖一半
- 双散列法
- 增量序列 \(d_i=iH_2(key),i=0,1,2,...\)
- 伪随机序列法
- 增量序列由一个伪随机生成器产生
散列查找及性能分析的应用
散列表的装填因子 \[ \alpha = \frac{表中记录数n}{散列表长度m} \] 显然,装填因子越大,越容易发生冲突。